Uptown Funk AI 手动生成手把手教程:从素材到成片完整复刻
最后更新:
如果你想了解 Uptown Funk AI 舞蹈视频的底层技术全貌,或希望在第三方平台与 API 环境中手动复刻出同款高质量成片,本篇教程将基于三份真实素材,手把手拆解角色绑定、提示词编写、无声视频生成及 FFmpeg 音画无损合成的完整工程流。
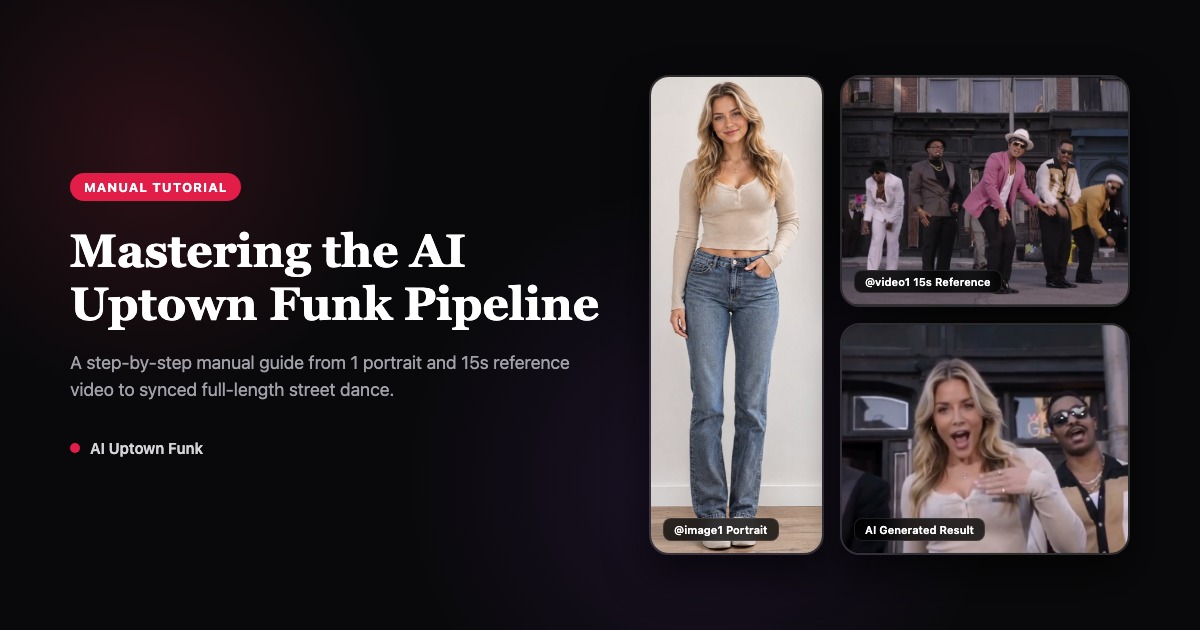
一、素材拆解与规范准备
手动复刻高质量 Uptown Funk AI 街舞的核心在于三份素材的分工配合:目标人物参考图、动作与运镜参考视频,以及后期高保真音轨。
1. 目标人物肖像(@image1):准备一张光线均匀、面朝镜头的单人全身照(例如米色长袖针织露脐上衣搭配经典蓝色牛仔长裤与白板鞋)。全身照能让多模态大模型同步捕获面部五官轮廓、发型、肢体比例与日常私服风格,避免因仅提供局部大头照而导致下半身着装被模型随意脑补。
2. 动作与运镜参考(@video1):截取恰好 15 秒、16:9 构图的 Uptown Funk 经典街舞原版视频(推荐 1080p 或 720p 24fps)。该视频仅用于向模型提供卡点节拍、走位调度、深蹲踢腿动作与摄影机推拉运镜,严格剥离其原始人物身份。
3. 最终交付目标:将原视频中的 Bruno Mars 替换为目标人物,全程保持其发型发色与便装穿搭,与两侧伴舞动作严丝合缝,并在后期贴回原版 AAC 立体声音轨。
二、核心原理与模型选择
在 Reference-to-Video(参考生视频)任务中,模型(如 ByteDance Seedance 2.0 Fast、Seedance 2.5 或快手可灵 Kling 4.0)通过多模态交叉注意力机制,将静止图像的视觉特征注入到动态视频的动作骨架中。
为什么必须在生成时关闭音频(generate_audio: false)?目前视频大模型原生生成的音频普遍存在底噪、音色失真且极难与复杂舞步精准卡点。行业最佳工程实践是“静音生视频 + 后期音轨混流”,确保成品音质达商业发布级。
当前档位为 Seedance 2.0 · 720p:99 积分;Seedance 2.0 Fast · 480p:69 积分;Seedance 2.0 · 1080p:149 积分;Seedance 2.5 · 720p:199 积分;Kling 4.0 · 720p:149 积分。比较结果时保持人物照片与参考一致;模型和分辨率本身不能保证人脸相似度。
三、第一步:平台配置与素材槽位绑定
在支持角色动作迁移的生成平台(如即梦 AI、可灵 AI 或 Kie.ai / SeeAPI 控制台)中进行如下配置:
1. 任务模式:选择「参考生视频 / Reference-to-Video」模式(请勿误选单图生视频模式,图生视频无法精确还原长达 15 秒的复杂镜头切换)。
2. 槽位绑定:在图像输入槽位 1 上传目标肖像(绑定为 @image1);在视频输入槽位 1 上传 15 秒原版街舞片段(绑定为 @video1)。
3. 生成参数:画面比例锁定为 16:9 横屏,生成时长设定为恰好 15 秒,输出分辨率建议选择 720p 或 1080p,关闭原生音频生成开关。
四、第二步:编写专业控制提示词(Prompt)
提示词的核心是建立明确的槽位映射、服装保留指令与负向约束。推荐使用如下经过实测验证的英文 Prompt:
@image1 is the center lead; keep identity and position fixed. @video1 provides choreography and camera timing, not identities. Keep each supplied person in their own everyday outfit. Sunny retro street with brick storefronts and striped awnings. Follow the reference dance and shot sequence. Keep faces distinct and movements natural. Keep feet visibly grounded, 5 fingers per hand, no distorted hands or merged limbs. No role swap, no face blending. No subtitles. Generate no audio.
核心控制点拆解:@image1 is the center lead 锁定人物在整个切镜过程中稳居 C 位;@video1 provides choreography, not identities 彻底阻断参考视频中原有明星长相的渗透;Keep feet visibly grounded, 5 fingers per hand 抑制 AI 舞蹈常见的滑步与手部形变;No role swap 确保在近景和全景切换时绝不发生串脸。
五、第三步:FFmpeg 一键混流贴回正版原声
生成任务完成后,下载输出的高清无声 MP4 视频(假设命名为 generated-silent.mp4)。最后一步是将 15 秒原版原声无损混流压入视频。
打开终端,运行如下单行 FFmpeg 命令:
ffmpeg -i generated-silent.mp4 -i uptown-funk-original-15s-1080p.mp4 -c:v copy -c:a aac -map 0:v:0 -map 1:a:0 -shortest -y uptown-funk-final.mp4
命令参数原理解析:-c:v copy 直接复用原视频编码流,避免二次编码画质损耗,秒级完成;-map 1:a:0 精准提取原版视频中的 AAC 立体声音轨;-shortest 确保音视频时间戳严格对齐。输出的 uptown-funk-final.mp4 即为完美的最终成品。
六、高频避坑与多人物扩展
1. 避免面部漂移:优先选用均匀自然光下拍摄的高清正面全身照,避免大面积侧光(阴阳脸)、深色墨镜或夸张美颜滤镜,确保模型能稳健识别人体骨骼关键点与面部几何结构。
2. 扩展至 2–5 人齐舞:若需要为好友或同事制作群舞,可在图片槽位依次传入多张照片:@image2 对应最左侧舞者,@image3 对应最右侧舞者,@image4 与 @image5 对应内侧伴舞,提示词补充对应映射即可。
3. 自动化与在线生成:若希望免去手动调试参数与脚本合成的繁琐步骤,可直接在 AI Uptown Funk 首页上传照片并选定造型,系统将在后台自动完成素材预处理、指令装配、排队生成与音轨贴回全流程。
让你的舞队跳起 Uptown Funk
制作我的舞队视频